
How Open Science Can Help Researchers Prepare for the Next Pandemic
Cuando la COVID-19 surgió, los científicos contaban con una ventaja crucial: décadas de investigación previa sobre coronavirus que les permitió entender las proteínas clave del virus y diseñar vacunas en tiempo récord. Sin embargo, la próxima pandemia podría no ofrecer el mismo punto de partida. Para mejorar las probabilidades, NVIDIA se ha unido a una coalición de organizaciones de investigación globales, incluyendo Google DeepMind y el Instituto Europeo de Bioinformática del Laboratorio Europeo de Biología Molecular (EMBL-EBI), para liberar estructuras 3D predichas para los complejos proteicos de más de 2,800 virus, disponibles abiertamente para cualquier científico, en cualquier lugar, a través de la Base de Datos AlphaFold.
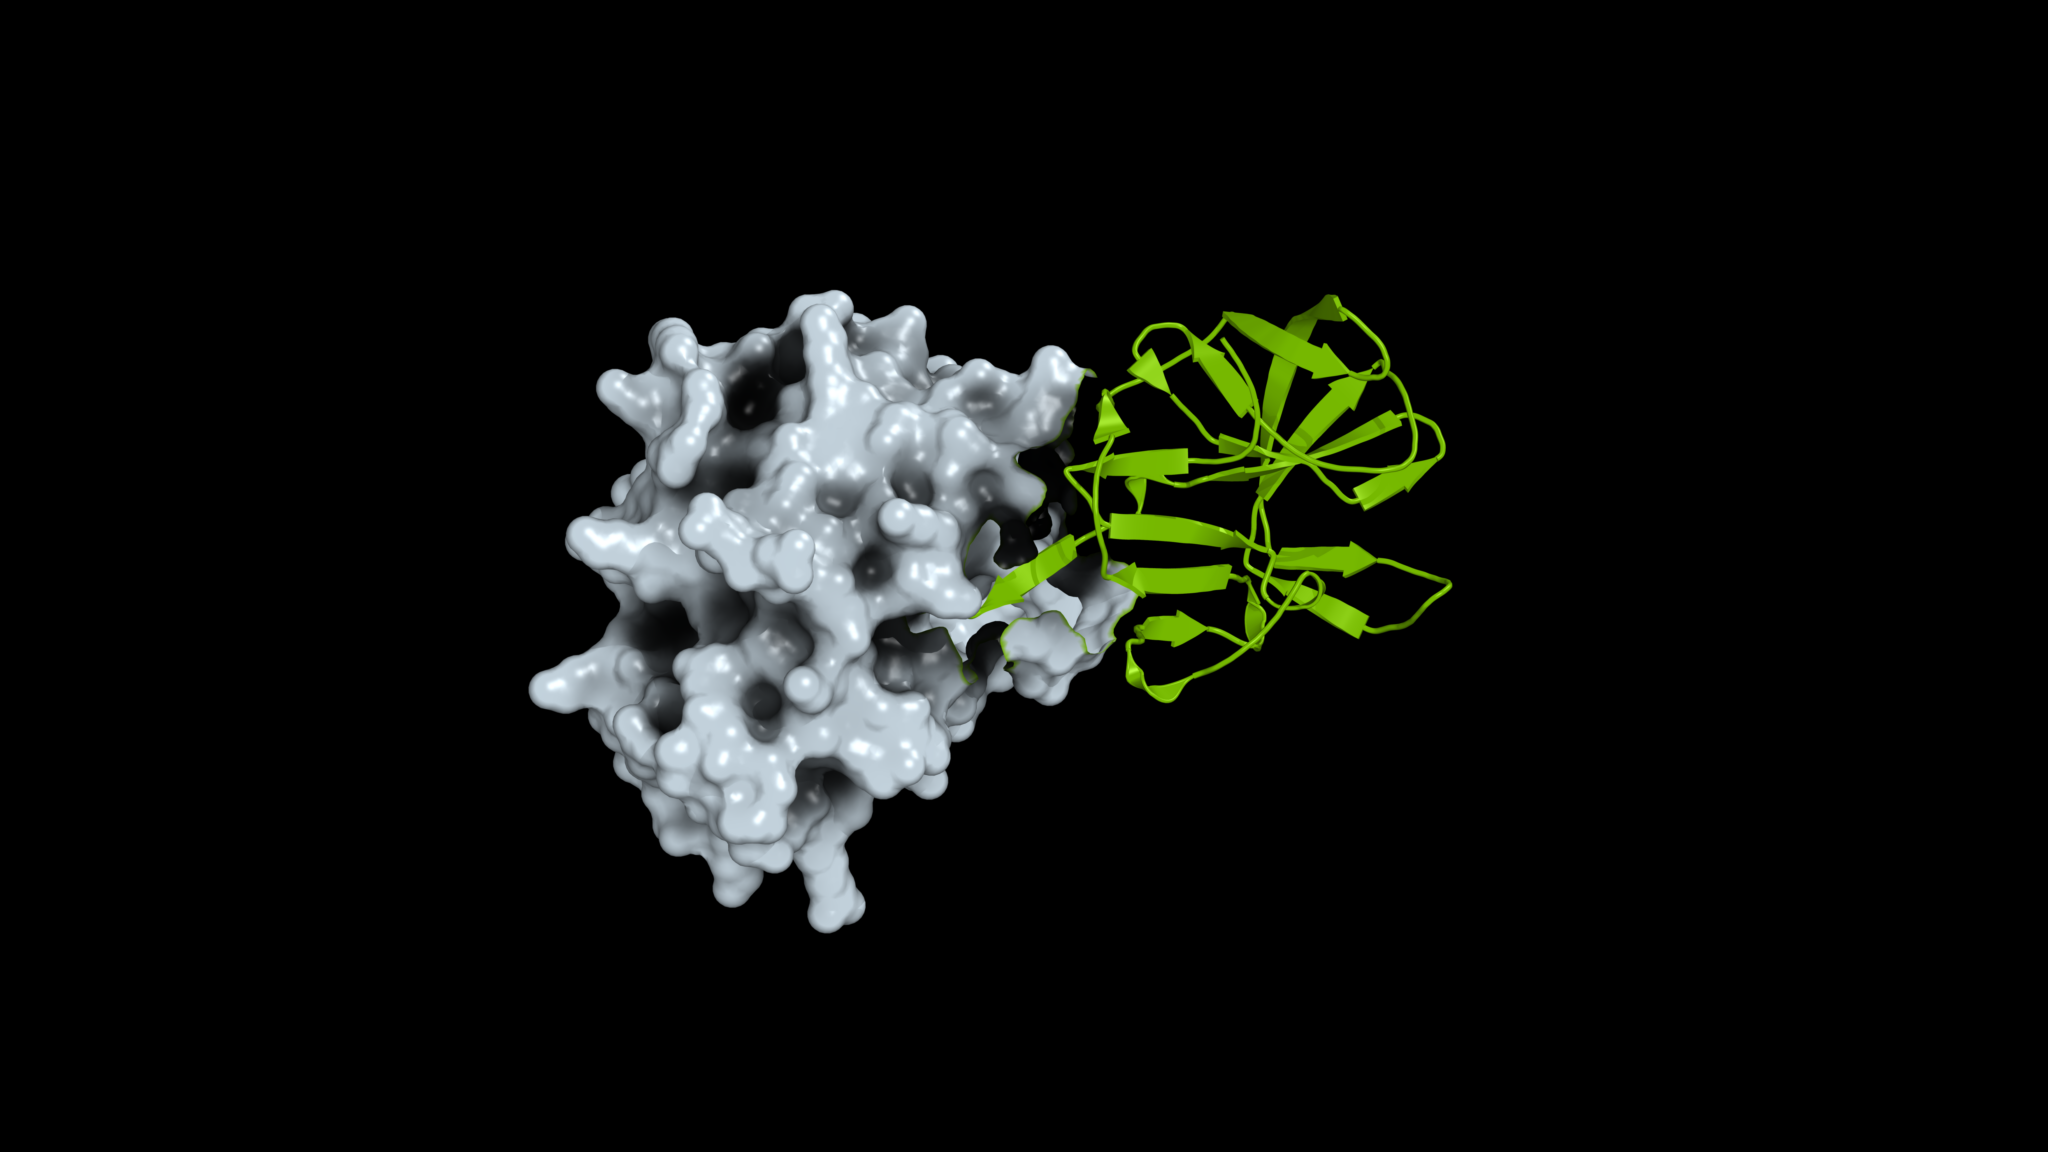
Las estructuras en el nuevo conjunto de datos fueron inferidas utilizando AlphaFold2, el modelo de IA de Google DeepMind para predecir cómo las proteínas se pliegan en formas 3D, con optimización del Runtime de Inferencia BioNeMo de NVIDIA. Esto permitió al equipo escalar la inferencia a miles de proteomas virales, prediciendo los complejos, o grupos de proteínas que interactúan, codificados dentro de cada virus.
«Nuestra ambición con la Base de Datos AlphaFold siempre ha sido democratizar el acceso a la biología fundamental a gran escala», dijo Risha Patel, gerente de asociaciones en ciencias de la vida en Google DeepMind. «Esta colaboración para llevar miles de complejos virales a la base de datos equipará a los científicos de todo el mundo con los conocimientos que necesitan para ayudar a prepararse para futuros brotes».
NVIDIA también está liberando abiertamente el Pipeline de Predicción de Estructuras BioNeMo, el flujo de trabajo acelerado por GPU utilizado para generar el conjunto de datos, para que los investigadores puedan pasar de la secuencia de proteínas a la estructura 3D predicha para sus propios objetivos.
La preparación para la próxima pandemia debe comenzar ahora. Un análisis del Centro para el Desarrollo Global estima una probabilidad de aproximadamente el 50% de que el mundo enfrente una pandemia tan severa como la COVID-19 para 2050.
«Cuando ocurra la próxima pandemia, puede haber algo que surja de la nada, y careceremos del conocimiento que teníamos para la COVID», dijo Joe Grove, profesor de virología molecular en el Centro de Investigación de Virus del Consejo de Investigación Médica-Universidad de Glasgow y colaborador en el proyecto. «Lo que estamos tratando de hacer es acumular parte de ese conocimiento con anticipación».
Cerca del 30% de las interacciones proteicas que se están agregando a la base de datos son completamente nuevas para la ciencia, mostrando formas de interacción que nunca se han documentado en el Banco de Datos de Proteínas, el principal repositorio de estructuras proteicas determinadas experimentalmente. Esto se traduce en nuevos conocimientos para que la comunidad biológica explore y aproveche para generar nuevo conocimiento.
«Esta base de datos es un motor para la generación de hipótesis», dijo Chris Dallago, líder del equipo de investigación aplicada en biología digital en NVIDIA. «Estamos permitiendo que los biólogos y la comunidad de IA investiguen las interacciones proteicas, no solo como moléculas individuales sino como complejos, para que todo el campo pueda avanzar».
La colaboración abarca la Coalición para las Innovaciones en la Preparación ante Epidemias, EMBL-EBI, Google DeepMind, NVIDIA, la Universidad Nacional de Seúl, la Universidad Sungkyunkwan, el Instituto Suizo de Bioinformática y la Universidad de Glasgow.
El lanzamiento del conjunto de datos, que coincide con una reunión de la Asamblea General de las Naciones Unidas convocada por el Foro Económico Mundial sobre prevención, preparación y respuesta ante pandemias que tiene lugar esta semana en la ciudad de Nueva York, contribuye a la Base de Datos AlphaFold, que ahora contiene más de 260 millones de predicciones de proteínas y complejos proteicos que cubren casi todas las proteínas catalogadas conocidas por la ciencia.
«Hacer que estos datos sean abiertos es crítico para entender los diagnósticos virales y desarrollar tratamientos y vacunas», dijo Jo McEntyre, director interino de EMBL-EBI. «El conjunto de datos también cubre virus menos estudiados y reduce las barreras para los científicos en entornos con pocos recursos que enfrentan brotes de primera mano».
Las predicciones en el conjunto de datos abierto están etiquetadas por confianza. Las estructuras muestran cómo podrían verse los complejos virales y cómo podrían interactuar las proteínas individuales dentro de un proteoma viral.
En general, los nuevos datos representan una contribución importante a la información disponible para los científicos en toda la biología digital y la investigación de enfermedades.
«Cuando hice mi doctorado, no había estructuras para ninguna de las proteínas que estábamos investigando. Era como trabajar en la oscuridad, teníamos que adivinar lo que estaba pasando», dijo Grove. «Este conjunto de datos es una herramienta poderosa para todos los investigadores que están haciendo su doctorado ahora, dándoles datos estructurales de alta calidad que van a acelerar la ciencia fundamental».